
Знакомая картина: статья первая в поисковой выдаче, а на тот же вопрос голосовой помощник отвечает, ссылаясь на кого-то другого. Отсюда вырос отдельный рынок услуг «оптимизация под нейросети», и первое, что стоит сделать, — открыть документацию поисковых систем и прочитать, что они сами об этом пишут.
Разберу, что там написано, что из этого следует и какую собственную ошибку мы нашли, пока разбирались.
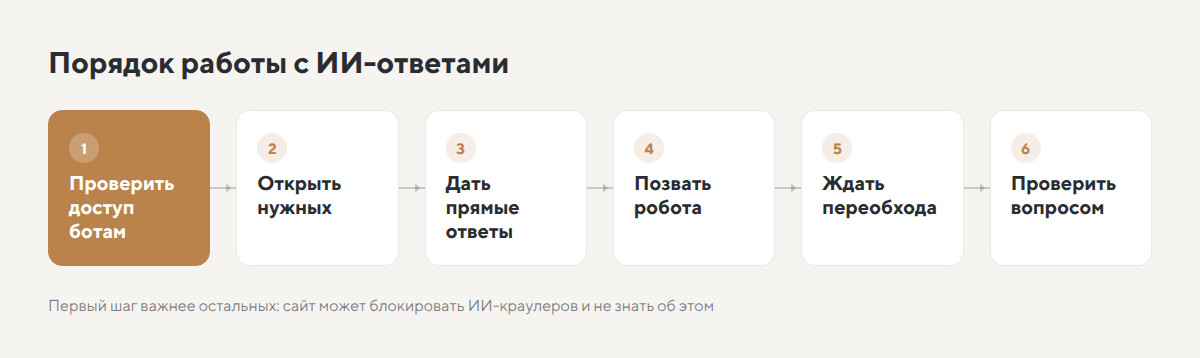
Первый шаг важнее остальных: сайт может блокировать ИИ-краулеров, и никто об этом не знает.
Что говорит документация
Google, раздел про ИИ-функции поиска: «Никаких дополнительных требований для появления в AI Overviews и AI Mode нет, как и особой оптимизации». И отдельно: не нужны ни новые машиночитаемые файлы, ни специальная разметка. Достаточно, чтобы страница была проиндексирована и соответствовала обычным требованиям поиска.
Яндекс, справка про быстрый ответ: специальной разметки нет, ответ формируется автоматически. Вероятность попасть выше, если страница проиндексирована, а «информация на ней тщательно структурирована, качественно и грамотно изложена». Нейросеть при этом собирает ответ из нескольких источников и умеет складывать его из разных частей одной страницы.
Скорость сайта сюда же: страница, которая долго открывается на телефоне, проигрывает позиции, а без позиций в ответ Алисы не попасть — разбор со своими цифрами.
Первый вывод, неприятный для продавцов новых услуг: отдельной «оптимизации под ИИ» не существует. Есть обычная работа — попасть в индекс, хорошо ранжироваться и написать текст, из которого можно вынуть ответ.
⚠️ Заодно про модный файл llms.txt — его ищут чаще, чем сами ИИ-ответы. Это предложение сообщества, а не требование поисковиков: Google прямым текстом пишет, что новые машиночитаемые файлы не нужны. Положить его можно, вреда не будет, но считать его причиной попадания в ответы — самообман.
SEO и GEO: в чём разница
За последний год у привычного SEO появился спутник — GEO, Generative Engine Optimization, оптимизация под генеративные ответы. Разница не в приёмах, а в том, за что идёт борьба.
SEO борется за место в списке ссылок. Успех измеряется позицией и переходом: человек увидел строку в выдаче, кликнул, пришёл на сайт. Работает всё, что влияет на ранжирование: соответствие запросу, скорость, структура, ссылки, поведение людей.
GEO борется за место в тексте ответа. Успех — модель взяла фрагмент из вашей статьи и назвала вас источником. Клика при этом может не быть вовсе: человек получил ответ и пошёл дальше, зато получил его вашими словами и с вашим именем рядом.
Отсюда три практических различия:
- Единица борьбы. В SEO — страница, в GEO — абзац: модель берёт кусок, который отвечает на вопрос сам по себе.
- Что измеряем. В SEO — позиции, показы, клики, и всё это видно в Вебмастере и Метрике. В GEO — упоминания и цитирования; до недавнего времени их мерили глазами, а теперь есть отчёт «Видимость сайта в Алисе AI» с долей упоминаний. Про этот отчёт — отдельный раздел.
- Кого пускать. В SEO вопроса о доступе нет — поисковых роботов пускают все. В GEO появляется отдельное решение: какие ИИ-краулеры пускать, а какие нет.
Распространённый тезис, который лучше не брать на веру
В статьях про GEO часто встречается такая формулировка: поисковые системы ориентируются на ключевые слова и технические сигналы, а нейросети считывают смысл целиком, оценивая достоверность источника и актуальность данных. Звучит убедительно, но разбирается на три неточности.
Первая. Поисковые системы перестали быть «про ключевые слова» задолго до нейросетей. И Яндекс, и Google ранжируют нейросетевыми моделями уже несколько лет: они разбирают смысл запроса, а не считают вхождения слов. Противопоставление «поиск про слова, ИИ про смысл» описывает поиск примерно десятилетней давности.
Вторая, и главная. Модель не обходит интернет в момент вашего вопроса. Сначала работает обычный поиск: он отбирает несколько подходящих страниц, и только потом нейросеть обобщает то, что ей подали. В справке Яндекса это сказано прямо — нейросеть «находит несколько самых подходящих источников». Практический вывод получается обратным исходному тезису: страница, которая не ранжируется, в ответ не попадёт, каким бы осмысленным ни был текст. Сначала SEO, потом всё остальное.
Третья. Обучение модели и ответ с поиском — разные процессы, и их постоянно путают. При обучении текст попадает в набор данных, и отбор там идёт фильтрами качества — это происходит задолго до вашего вопроса и без ссылок на вас. В ответе с поиском источники отбирает поисковая часть, здесь и появляется ссылка. Совет «повышайте достоверность, чтобы модель вас выбрала» смешивает эти два процесса и потому ни к чему не ведёт.
Что из этого тезиса всё-таки верно: фрагмент оценивается вместе с контекстом. Абзац, который отвечает на вопрос сам по себе, имеет преимущество перед тем, что понятен только после трёх предыдущих. Это и есть единственный практический совет, который стоит из него вынести.
⚠️ Но, судя по документации, «GEO как отдельная техническая дисциплина» — во многом маркетинг. Требований, которых не было бы в обычном SEO, поисковые системы не выдвигают: сначала надо хорошо ранжироваться, и только потом появляется шанс попасть в ответ. По существу GEO добавляет две вещи — писать так, чтобы из текста можно было вынуть готовый ответ, и следить за доступом ИИ-краулеров. Остальное — то же SEO под новым именем.
⚠️ Деталь из замера частотности: по-русски «geo оптимизация» спрашивают около 940 раз в месяц, но почти все эти люди имеют в виду географию — карты, регионы, локальное продвижение. Термин в русском поиске занят, и целиться в него бессмысленно.
Что действительно мешает: вы сами
Пока изучали документацию, проверили себя — и нашли вот что. В конфигурации веб-сервера стоит защита от скребков контента: тех, кто выкачивает сайты для чужих SEO-сервисов и создаёт нагрузку без всякой пользы. Правило ставится при настройке сервера, вместе с остальной базовой защитой:
@badbots header_regexp User-Agent (?i)(ahrefsbot|semrushbot|mj12bot|dotbot|
petalbot|blexbot|dataforseo|megaindex|serpstatbot|zoominfobot|gptbot|ccbot|
claudebot|bytespider|amazonbot|sqlmap|nikto|nmap|masscan|fuzz)
abort @badbots
Найдите в этом списке gptbot, claudebot, ccbot. Когда правило писалось, они выглядели ровно как остальные — роботы, которые ходят и забирают текст. В результате сайт молча обрывал соединение с краулерами OpenAI и Anthropic.
Проверяется это одной командой на каждый бот:
curl -s -o /dev/null -w "%{http_code}\n" \
  -A "Mozilla/5.0 (compatible; GPTBot/1.0)" \
  https://example.com/
Код 200 — бот пустили. 403 — закрыли явно. 000 — соединение оборвано, и именно это мы у себя и увидели.
Боты разные, и это главное
Ключевая деталь, из-за которой общий запрет по слову «бот» оказался вредным: у одной компании несколько краулеров под разные задачи, и по имени они различаются.
| Бот | Зачем ходит |
|---|---|
GPTBot | забирает тексты в обучающие наборы OpenAI |
OAI-SearchBot | индексирует для поиска внутри ChatGPT |
ChatGPT-User | заходит на страницу, когда пользователь задал вопрос прямо сейчас |
ClaudeBot | обучающие наборы Anthropic |
Claude-SearchBot, Claude-User | поиск и переход по вопросу пользователя |
YandexAdditional | быстрые ответы Яндекса |
PerplexityBot | поиск Perplexity |
Разница принципиальная. Обучающий краулер забирает текст в набор данных — ссылки на вас там не будет. Поисковый приходит за страницей, чтобы ответить человеку сейчас, и в ответе стоит ссылка на источник.
⚠️ Если решите блокировать «всё, что от OpenAI», вы выпадете из ответов ChatGPT целиком — вместе со ссылками на себя. Именно поэтому список ведётся по именам ботов, а не по названиям компаний.
Пускать ли обучающих: аргумент, который перевесил
Первым решением было: поисковых пускаем, обучающих нет — ссылка единственное, что мы получаем взамен текста, а обучающий краулер ссылок не даёт.
Потом сформулировался контраргумент, и он сильнее. Модель запоминает то, что видела при обучении. Поисковый бот даёт ответ сегодня и только пока страница в индексе; обучающий — шанс на то, что через год ассистент ответит про вашу тему вашими словами, вообще не заходя в интернет.
Что стоит взвесить, решая у себя:
- Насколько редкая у вас фактура. Пересказ общих мест модель и так знает от тысячи других сайтов — открывать их бессмысленно. А вот описание реальных граблей конкретной интеграции, цифры из своей практики, разбор ошибки, которую больше нигде не описали, — это то, чего в наборах мало.
- Что вы теряете. Практически ничего: обучающий краулер не отнимает трафик и не конкурирует с вами в выдаче. Расход — нагрузка на сервер.
- Чего не получите. Ссылки и перехода. И проверить, «запомнили ли вас», нельзя никак: обучение идёт раз в год-полтора, обратной связи нет.
- Что делают конкуренты. Если они открыты, а вы закрыты, в наборах окажутся их формулировки, а не ваши.
Наше решение после этого: пускаем и обучающих — но не всех. GPTBot и ClaudeBot открыли: это краулеры двух крупных моделей, где «память» и может однажды сыграть. CCBot оставили закрытым — он собирает выгрузку Common Crawl, которую потом берёт кто угодно, включая тех самых скребков, ради которых правило и писалось. Bytespider закрыт из-за нагрузки.
# Поисковые боты и обучающие GPTBot / ClaudeBot ходят свободно —
# им хватает общего «Allow: /».

User-agent: CCBot
Disallow: /

User-agent: Bytespider
Disallow: /
⚠️ robots.txt — просьба, а не запрет: реально закрывает доступ конфигурация сервера. Держите оба места согласованными, иначе получится как у нас: сервер обрывал соединение, а в robots.txt об этом не было ни слова.
⚠️ И честная оговорка, без которой совет был бы нечестным: эффект от обучающих краулеров непроверяем. Это ставка, а не инструмент с измеримым результатом. Тем, кто продаёт контент или живёт с рекламы на страницах, я бы советовал обратное — там текст и есть товар.
Сколько их вообще: проверьте весь список
Когда решение принято, остаётся выяснить, к кому оно применяется. Мы прогнали по своему сайту всех известных краулеров — и картина оказалась не той, что была в голове.
| Бот | Что делает |
|---|---|
GPTBot, OAI-SearchBot, ChatGPT-User | OpenAI: обучение, индекс поиска, заход по вопросу |
ClaudeBot, Claude-SearchBot, Claude-User | Anthropic: то же тремя ботами |
Googlebot, Google-Extended | поиск и AI Overviews; второй — обучение Gemini |
YandexBot, YandexAdditional | поиск и быстрые ответы с Нейро |
PerplexityBot, Perplexity-User | индекс и заход по вопросу |
Applebot, Applebot-Extended | Siri и Spotlight; второй — обучение |
meta-externalagent, Meta-ExternalFetcher | обучение моделей Meta и переход по ссылке |
Amazonbot, PetalBot | ассистент Alexa и поиск Huawei |
MistralAI-User, DuckAssistBot, YouBot | ассистенты, заходят по вопросу пользователя |
CCBot, Bytespider | выгрузка Common Crawl и сбор ByteDance |
cohere-ai, Diffbot, AI2Bot, ImagesiftBot | сбор данных и датасеты |
Два наблюдения из этой таблицы — они и есть главная польза от проверки.
Список блокировок — это не политика, а наследство. Он собирается при настройке сервера из имён известных скребков и дальше только пополняется: заметили нового — дописали. Пересматривать его целиком поводов не возникает, и позиция по ИИ-краулерам складывается сама собой, из решений, принятых для совсем других роботов. Увидеть это можно только проверкой.
Часть имён попала в список по прежней роли. Amazonbot мы считали выкачивателем, хотя за ним стоит ассистент, отвечающий пользователям. PetalBot числился скребком, хотя это поисковик Huawei со своим ассистентом. Оба приводят человека и ставят ссылку — то есть подпадают ровно под то правило, по которому мы пускаем поисковых ботов OpenAI. Открыли.
⚠️ И обратная сторона: открытым по недосмотру оказалось больше, чем закрытым. Google-Extended, Applebot-Extended, meta-externalagent, cohere-ai, Diffbot, AI2Bot ходили свободно — не потому что мы так решили, а потому что их имён не было в старом списке. Если у вас есть позиция по обучающим краулерам, проверьте, соответствует ли ей реальность: скорее всего, нет.
Проверка занимает пять минут — тем же curl по списку имён. Полезно повторять раз в полгода: новые боты появляются чаще, чем обновляются конфигурации.
Что зависит от текста
Вторая половина работы — сделать так, чтобы из статьи можно было вынуть ответ. В ИИ-ответ попадает не страница целиком, а фрагмент, который сам по себе отвечает на вопрос.
Разборы обычно устроены наоборот: сначала история, потом объяснение, вывод в конце абзаца. Читателю так лучше, а вытащить готовый кусок нельзя — и модель берёт текст попроще, даже если он ниже в выдаче.
Что помогает:
- прямой ответ первым предложением раздела, а объяснение следом;
- конкретика: числа, сроки, названия методов — их цитируют охотнее рассуждений;
- списки и таблицы вместо сплошного текста;
- блок «Вопросы и ответы» в конце статьи — самый простой способ дать готовые фрагменты.
Про вопросы в конце: выдаче они не навредят
Частый страх: «а не испортит ли блок вопросов сниппет и позиции». Отвечаю по документации.
Расширенные результаты FAQ Google перестал показывать: с сентября 2023 года они остались только у известных государственных и медицинских сайтов, а в мае 2026 показ прекратился совсем — документацию удалили в июне. При этом Google рекомендует оставить разметку на сайте: её используют другие поисковые системы и сервисы, чтобы лучше понимать содержимое.
То есть картина такая: видимых плюшек в выдаче разметка больше не даёт, но и не вредит. А сам блок вопросов полезен дважды — человеку, который хочет короткий ответ без чтения десяти абзацев, и машине, которой нужен готовый фрагмент.
Единственное правило: ответ должен быть законченным. Никаких «как сказано выше» — фрагмент показывают отдельно от статьи, там нет контекста.
Как Алиса собирает ответ — и почему это меняет то, как писать
Яндекс описал механику, и она объясняет, почему одни статьи цитируют, а другие нет.
Получив вопрос, Алиса разбивает его на подвопросы. Пример из справки: запрос «хоккей удаление до конца матча» превращается в два — «как называется удаление до конца матча» и «за какие нарушения назначается матч-штраф». С уточнёнными формулировками она идёт в обычный поиск, а из его результатов собирает ответ по смысловым блокам: сначала короткий вывод в одно-два предложения, дальше разделы по частям вопроса.
Отсюда следует вещь, которая меняет привычку писать: текст нужен под подвопросы, а не под одну фразу. Каждый раздел должен закрывать свой вопрос целиком, потому что именно раздел, а не статья, становится источником абзаца в ответе.
Ссылки на источники внутри ответа устроены иначе, чем выдача:
- они не ранжируются — стоят в том порядке, в каком того требует смысл ответа;
- их может быть больше, чем ссылок на странице обычного поиска;
- в одном ответе могут стоять разные страницы одного сайта;
- одна страница может повториться, если она источник сразу для нескольких абзацев.
Последний пункт — практический аргумент в пользу большого разбора против россыпи коротких заметок: подробный материал с ясной структурой способен дать несколько попаданий в один и тот же ответ.
Ещё одна деталь: дословно Алиса не цитирует — кроме прямой речи. Живая цитата в тексте имеет шанс попасть в ответ как есть.
Источники отбираются по четырём признакам: экспертность, полезность, оригинальность, содержательность. Это ровно то, что нельзя изобразить разметкой, — и объясняет, почему в ИИ-ответы чаще попадают тексты, написанные теми, кто делал работу руками.
Как теперь измерить, а не угадывать
Главная слабость всей темы была в том, что результат не измерялся: спросил ассистента, увидел чужую ссылку — вот и вся аналитика. Теперь в Яндекс.Вебмастере есть отчёт «Видимость сайта в Алисе AI».
Что в нём:
- Share of Voice — доля запросов, где упомянут ваш сайт, среди всех запросов, на которые Алиса отвечала. Показывается графиком, видно динамику.
- Диапазон частоты — попадает ли сайт в топ-3, топ-10 или топ-20 по упоминаниям. Нет такой отметки — значит упоминают редко.
- Примеры запросов с указанием, какие страницы Алиса взяла источниками. Есть фильтр «запросы с моим сайтом» и выгрузка списка.
- Сайты, которых цитируют по тем же темам — заодно список конкурентов по нише и площадок, где имеет смысл появиться.
Данные за три месяца, обновляются раз в неделю.
Две оговорки, без которых цифру прочитают неправильно.
Первая: считается только по запросам, где сайт уже высоко в выдаче. Это сделано намеренно, чтобы показатель не размывался случайными темами, — но и означает, что SEO остаётся условием входа. Алиса строит ответ по страницам, которые и так занимают верхние позиции: сначала надо попасть наверх, и только потом бороться за цитирование.
Вторая: кликов и показов там нет — только доля упоминаний. Связать этот график с заявками напрямую не выйдет.
И ещё: ответ каждый раз собирается заново, набор источников по одному запросу меняется в разные дни и даже часы. Поэтому единичная проверка «спросил — нас нет» ничего не доказывает; смотреть надо на долю в динамике.
Зачем это вообще нужно, если переходов оттуда немного? Есть цифра: исследование сервиса веб-аналитики Microsoft Clarity 2025 года, больше 1200 информационных и новостных сайтов. Пришедшие из ИИ-ответа совершают целевое действие заметно чаще тех, кто пришёл из обычной выдачи, — на подписку втрое чаще. Аудитория оттуда меньше, но она приходит уже с ответом и доверием к источнику.
Порядок действий
- Проверьте, кого вы пускаете. Командой выше, по каждому боту. Это пять минут, и это единственный шаг, который может внезапно обнаружить, что вы невидимы для половины сервисов.
- Согласуйте
robots.txtи конфигурацию сервера — они должны говорить одно и то же. - Дайте прямые ответы в тексте и блок вопросов в конце.
- Позовите робота: новые и обновлённые страницы — в очередь переобхода Вебмастера, иначе ждать своей очереди можно неделями.
- Проверяйте не сразу. Индексация, переоценка страницы и попадание в ответы занимают недели. Практичнее всего просто задать свой вопрос голосом и посмотреть, из чьих слов собран ответ.
Как устроена очередь переобхода и почему инструмента «Оригинальные тексты» в Вебмастере больше нет — тема отдельная; если коротко, авторство сейчас защищает не заявка, а скорость индексации оригинала.
Главное: цель — видимость, а не модный термин
Вокруг ИИ-ответов уже сложился рынок услуг с новыми названиями, и легко начать гнаться за термином вместо результата. Стоит держать в голове простую вещь: задача не в том, чтобы «делать GEO», а в том, чтобы вас находили.
Инструменты меняются каждые несколько лет: были ключевые слова, потом поведенческие факторы, теперь генеративные ответы. А работает всё это время одно и то же:
- сайт доступен роботам — всем, кого вы осознанно решили пускать;
- страницы в индексе, и вы знаете, каких там нет;
- текст отвечает на вопрос человека лучше соседних по выдаче;
- из этого текста можно вынуть готовый ответ.
Первые два пункта — гигиена, без которой остальное бессмысленно, и именно на ней мы нашли у себя оборванных краулеров. Третий — обычная работа над содержанием, не устаревшая ни разу за двадцать лет. Четвёртый — то новое, что действительно принесли ИИ-ответы, и весь он умещается в «пишите так, чтобы абзац отвечал сам по себе».
Проверять результат стоит не по названию услуги в договоре, а по одному вопросу: стало ли вас видно больше. В поиске это позиции и переходы, в ИИ-ответах — упоминания и ссылки на вас. Всё остальное — способ туда попасть, и способы будут меняться.
Если хотите разобраться со своим сайтом
Проверка занимает немного, а находит обычно неожиданное: закрытых ботов, расхождение между robots.txt и сервером, страницы, до которых робот не дошёл. Что делаем:
- проверяем доступ поисковых и ИИ-краулеров, приводим правила к одному виду;
- смотрим индексацию: что в поиске, что исключено и почему;
- правим структуру статей так, чтобы из них можно было вынуть ответ;
- настраиваем переобход при публикации, чтобы новое попадало в индекс сразу;
- показываем, как это проверять самим — без подписки на «оптимизацию под ИИ».
Хотите такую проверку — расскажите о задаче.
Коротко: частые вопросы
- Нужна ли специальная оптимизация под нейросети?
- Нет. Google прямо пишет, что дополнительных требований для попадания в AI Overviews нет и особая оптимизация не нужна; Яндекс — что специальной разметки не существует, ответ формируется автоматически. Работает обычное: индексация, ранжирование и текст, из которого можно вынуть готовый ответ.
- Нужен ли файл llms.txt?
- Это предложение сообщества, а не требование поисковых систем: Google отдельно указывает, что новые машиночитаемые файлы не нужны. Положить его можно, вреда не будет, но считать причиной попадания в ответы не стоит.
- Стоит ли пускать обучающие краулеры вроде GPTBot?
- Зависит от того, чем вы живёте. Ссылок и переходов они не дают, но модель запоминает то, что видела при обучении, — и через год может отвечать по вашей теме вашими словами. Если фактура редкая и вы не продаёте сам контент, пускать имеет смысл; если текст и есть товар — нет.
- Не испортит ли блок вопросов в конце статьи поисковую выдачу?
- Нет. Расширенные результаты FAQ Google перестал показывать в мае 2026 года, но рекомендует оставить разметку: её используют другие системы для понимания содержимого. Видимых плюшек она не даёт, вреда тоже; сам блок полезен человеку и даёт машине готовый фрагмент.
- Чем GEO отличается от SEO?
- SEO борется за место в списке ссылок: успех — позиция и переход на сайт. GEO (Generative Engine Optimization) борется за место в тексте ответа: успех — модель взяла фрагмент вашей статьи и назвала вас источником, а клика может не быть вовсе. Единица борьбы разная: в SEO — страница, в GEO — абзац, который отвечает на вопрос сам по себе.
- Правда ли, что поисковики смотрят на ключевые слова, а нейросети — на смысл?
- Нет, это устаревшее противопоставление. И Яндекс, и Google ранжируют нейросетевыми моделями уже несколько лет и разбирают смысл запроса. А в генеративном ответе сначала работает обычный поиск: он отбирает несколько источников, и только потом нейросеть обобщает поданное. Поэтому страница, которая не ранжируется, в ответ не попадёт, каким бы осмысленным ни был текст.
- С чего начать, если хочется попасть в ИИ-ответы?
- С проверки, кого вы пускаете на сайт, и с индексации: страница, которой нет в индексе, в ответ не попадёт. Дальше — обычная работа над текстом плюс одно новое требование: абзац должен отвечать на вопрос сам по себе. Гнаться за термином не нужно, цель — видимость сайта, а не название услуги.